Relatório preliminar. O universo pode ter mudado desde a coleta dos dados.
Kimi K3: esforço "max" não move o placar de GPQA
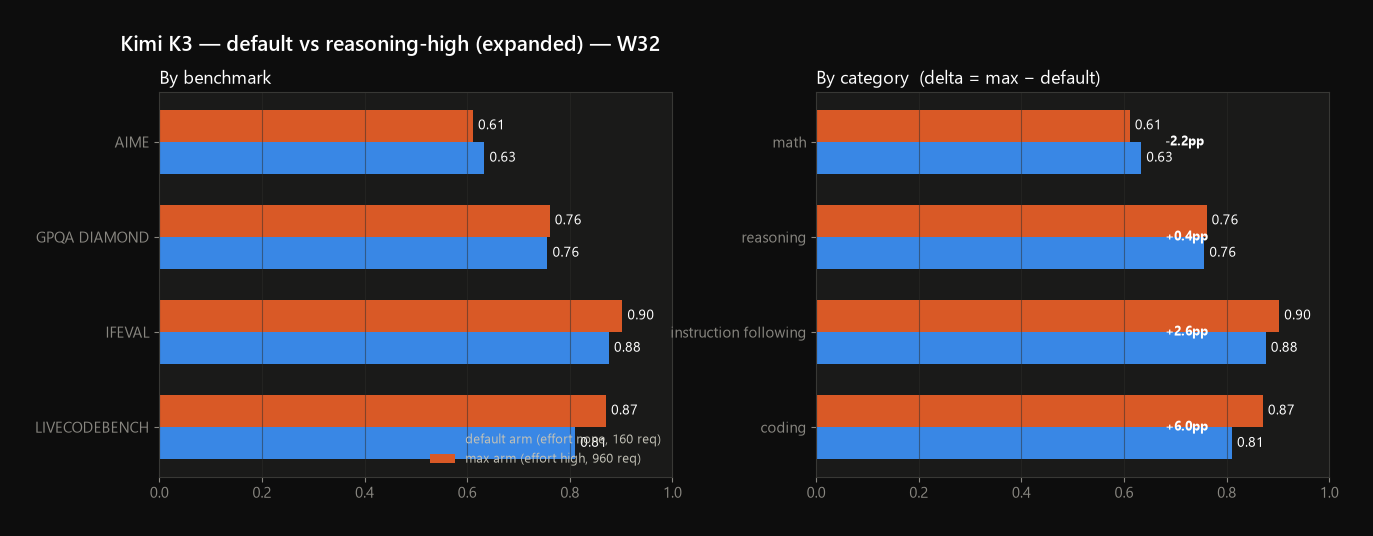
Este é um follow-up curto ao post do espelho e ao post de custo default vs max. Mesmo espelho de terceiros (supxh), mesma suíte, os mesmos dois runs medidos em 2026-08-09. A pergunta aqui é mais estreita que custo: o braço "max" amostrou o GPQA Diamond sete vezes mais que o braço comum — 160 tentativas (40 questões × 4 permutações) contra 1120 tentativas (80 × 4 × 3 repetições) — e o placar andou meio ponto percentual. Quando multiplicar a evidência por sete muda a resposta em 0,5pp, o que você está vendo não é esforço trabalhando. É o desempenho estável do endpoint, reamostrado.
O número que não andou
| Braço | GPQA Diamond | n | Marvin Score | Chamadas | Erros |
|---|---|---|---|---|---|
| kimi-k3@supxh (default) | 75,6% | 160 | 0.767 | 348 | 1 |
| kimi-k3-max@supxh (max) | 76,1% | 1120 | 0.786 | 1308 | 0 |
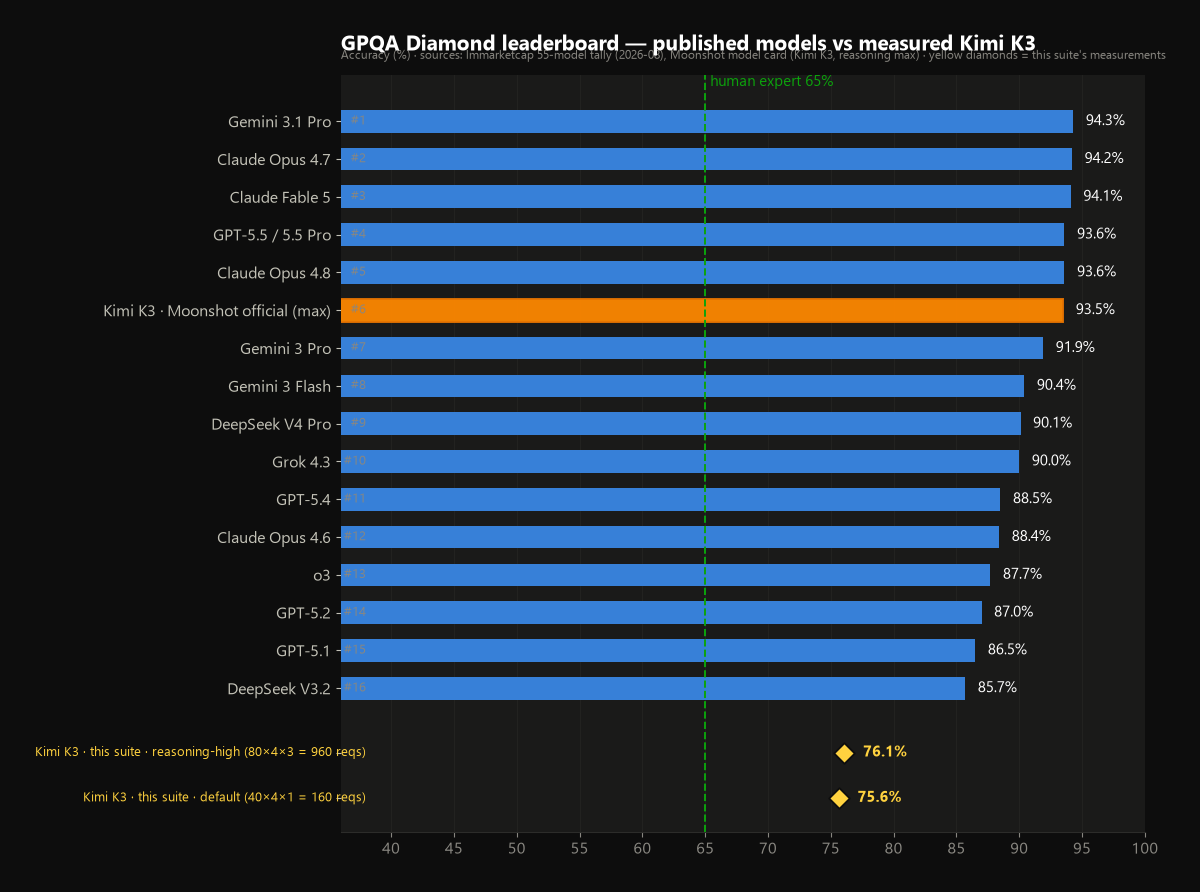
A figura publicada pela Moonshot para Kimi K3 em GPQA Diamond é 93,5% (reasoning max). Os dois braços medidos ficam ~17–18 pontos abaixo dela e ~10–11 pontos acima da linha de especialista humano (65%). O braço max não é o modelo publicado; é o mesmo espelho, e ele não chega mais perto do número publicado por se esforçar mais.
Medido vs publicado
O gráfico acima é o quadro completo: nossos números ao lado dos publicados para os mesmos benchmarks. A coluna publicada é contexto, não ranking — conjuntos de dados, orçamentos e conexão diferentes — e ela nunca entra no Marvin Score.
| Benchmark | Medido aqui (default · max) | Publicado em outro lugar | Fonte |
|---|---|---|---|
| gpqa_diamond | 0.756 · 0.761 | Kimi K3 0.94 (reasoning max) | model card |
| aime | 0.633 · 0.611 | Kimi K3 0.96 | blog |
A figura de GPQA da Moonshot é oficial, com configurações declaradas (esforço max, temperatura 1.0, top_p 0.95); a figura de AIME é tier blog e ausente do model card oficial, que publica GPQA Diamond e benchmarks agênticos apenas. Os dois braços medidos ficam ~17–18 pontos abaixo do GPQA publicado e ~33–35 abaixo do AIME publicado. A distância é protocolo, dataset e espelho — números publicados vêm de conjuntos completos, orçamentos de tokens maiores e conexão direta, nada disso sobrevive neste espelho — não o campo de effort, e não o tamanho da amostra.
O canal de raciocínio: majoritariamente vazio, e mudo onde deveria falar
A premissa inteira do braço "max" é um orçamento de raciocínio. O canal que ele deveria comprar não apareceu: o raciocínio voltou vazio em 946 de 1308 chamadas (72%) no run max — incluindo 90/90 no AIME, 80/80 no IFEval e 18/18 no LiveCodeBench. Onde apareceu (362 chamadas, todas de GPQA), o journal de extração registra 37,1% das respostas de GPQA pontuadas vindas do raciocínio contra 62,8% do texto final — então quando o canal disparou, ele carregava sinal real. O braço comum nunca o viu: 0 raciocínio em 348/348 chamadas.
O placar não liga. O braço com 0 raciocínio marcou 75,6%; o braço em que o raciocínio disparou em cerca de um terço das chamadas de GPQA marcou 76,1%. O post anterior mostrou a mesma coisa nos 160 itens que ambos os braços responderam: o max marcou menos lá (0.733 vs 0.756) — o +0.5pp agregado vem do sorteio de itens diferente, não do esforço. O espelho não honra reasoning.effort (estabelecido no post do espelho: um tier fajuto retorna 200 e o canal aparece e desaparece sem correlação com o campo), então o braço "max" deve ser lido como uma amostra maior do mesmo endpoint.
O que isso significa
Sete vezes a amostra, meio ponto. O esforço de raciocínio não altera o resultado mensurável, e o canal de raciocínio que o esforço deveria comprar volta vazio em quase três quartos das chamadas no espelho. A distância até os 93,5% publicados é protocolo, dataset e espelho — não o campo de effort, e não o tamanho da amostra.
O Ministério Interplanetário de Infraestrutura recomenda gastar orçamentos de raciocínio em endpoints que demonstravelmente os usam, e manter os tratados frágeis.