Relatório preliminar. O universo pode ter mudado desde a coleta dos dados.
Lineup do Marvin Router — todos os modelos que já passaram pela bancada
Este documento consolida o que a suíte marvinbench já mediu até aqui. Não é um ranking — e o motivo de não ser é parte do achado: cinco modelos passaram pela bancada, mas não pela mesma bateria. Três runs completaram benchmarks públicos (AIME, IFEval, LiveCodeBench, GPQA); dois modelos têm apenas uma célula medida (structured output, num run smoke com suíte própria). O placar abaixo mostra exatamente onde cada modelo foi medido — e onde a bancada ainda tem buracos.
Os dados ficaram no store SQLite do benchmark em 2026-08-09 e os números citados vêm dos results.json exportados. Medições de provedor e de espelho já têm posts próprios (mesmo modelo, provedor diferente e Kimi K3 por um espelho); este post é a vista de conjunto — o lineup — com a lacuna exposta.
O lineup
| Braço | Run | Suíte | Marvin Score | Confiab. | Latência p50 | tok/s | Benchmarks |
|---|---|---|---|---|---|---|---|
| DeepSeek-V4-Flash@marvin | 2026-W32 | 478e23a78ea1 | 0.846 | 99.2% | 7.8s | 128 | 9 (completa) |
| DeepSeek-V4-Flash@openrouter | 2026-W32-public | 1d2792e98840 | 0.756 | 91.0% | 20.1s | 792 | 3 |
| kimi-k3@supxh | 2026-W32-kimi | 478e23a78ea1 | 0.767 | 99.7% | 7.7s | 159 | 4 |
| kimi-k3-max@supxh | 2026-W32-kimi-max | 478e23a78ea1 | 0.786 | 100% | 5.6s | 183 | 4 |
| MiniMax-M3 | smoke | 487f133ae885 | 1.000 | 100% | 2.2s | 20 | 1 (só structured output) |
| qwen3.6 | smoke | 487f133ae885 | 1.000 | 100% | 1.9s | 25 | 1 (só structured output) |
Não compare os Marvin Scores entre linhas. O score é calculado sobre os benchmarks que o run executou — e os runs não executaram os mesmos conjuntos. O 1.000 do MiniMax-M3 e do qwen3.6 é uma única célula (12 tentativas de marvin_json); o 0.846 do DeepSeek-V4-Flash é uma média de nove benchmarks (261 tentativas). O mesmo valor em linhas diferentes significa coisas diferentes. É exatamente essa assimetria que o placar abaixo torna visível.
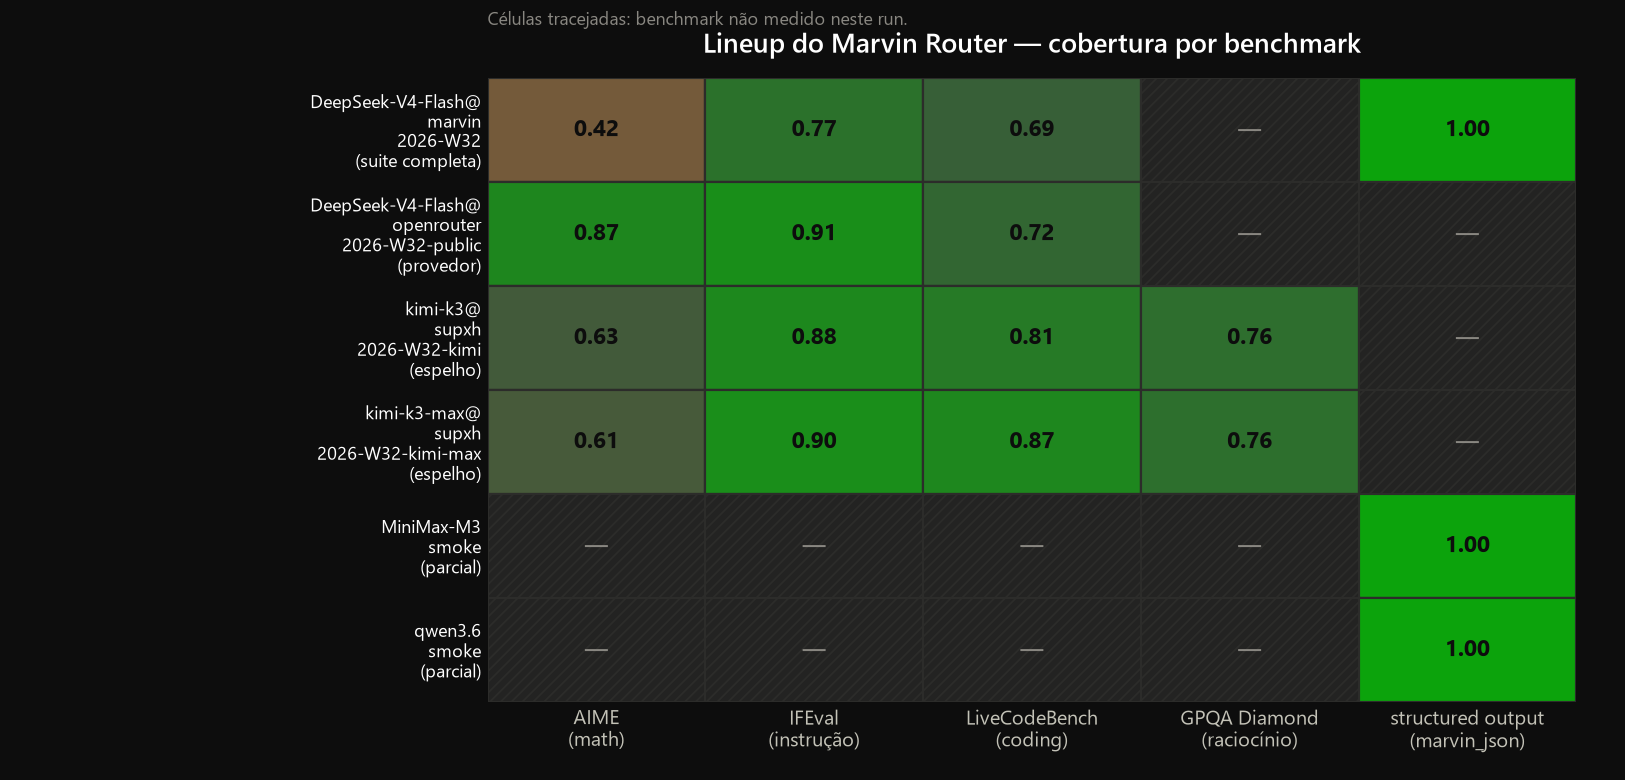
A lacuna
| Benchmark | DS-V4-Flash@marvin | DS-V4-Flash@openrouter | kimi-k3 | kimi-k3-max | MiniMax-M3 | qwen3.6 |
|---|---|---|---|---|---|---|
| aime | 0.42 (n=90) | 0.87 (n=90) | 0.63 (n=90) | 0.61 (n=90) | — | — |
| ifeval | 0.77 (n=80) | 0.91 (n=80) | 0.88 (n=80) | 0.90 (n=80) | — | — |
| livecodebench | 0.69 (n=18) | 0.72 (n=18) | 0.81 (n=18) | 0.87 (n=18) | — | — |
| gpqa_diamond | — | — | 0.76 (n=160) | 0.76 (n=1120) | — | — |
| marvin_json | 1.00 (n=6) | — | — | — | 1.00 (n=12) | 1.00 (n=12) |
Dois fatos sobre essa tabela. Primeiro: AIME, IFEval e LiveCodeBench têm quatro linhas preenchidas — DeepSeek (marvin e openrouter) e os dois Kimi — e são os únicos benchmarks onde existe comparação possível entre braços. Segundo: MiniMax-M3 e qwen3.6 só têm structured output. Eles nunca enfrentaram AIME, IFEval, LiveCodeBench ou GPQA. O que se sabe deles: respondem JSON conforme o schema em 12 de 12 tentativas, com latência p50 de ~2s e tok/s ~20–25. Não se sabe se raciocinam, se seguem instruções longas, se codam — e, dado que o placar de math já mostrou um colapso de 0.87 para 0.24 trocando só de endpoint, dizer qualquer coisa sobre a qualidade desses dois sem a bateria completa seria adivinhação.
Os números que já dá para comparar
Entre os quatro braços com bateria, o quadro por benchmark:
- AIME:
DeepSeek-V4-Flash@openrouter0.87 lidera;kimi-k30.63 ekimi-k3-max0.61 empatam em segundo;DeepSeek-V4-Flash@marvin0.42 (bateria completa) — lembrando que o mesmo endpoint marcou 0.244 no run público (suíte1d2792e98840, só 3 benchmarks), um delta de 0.18 entre dois runs do mesmo dia. - IFEval:
openrouter0.91,kimi-k3-max0.90,kimi-k30.88,marvin0.77. - LiveCodeBench (n=18):
kimi-k3-max0.87,kimi-k30.81,openrouter0.72,marvin0.69. A célula mais ruidosa da suíte — o post do provedor já mostrou que n=18 não distingue dois endpoints; não distingue dois modelos também. - GPQA Diamond: só os Kimi foram medidos (0.76 ambos, com n diferente: 160 vs 1120) — e o post do espelho mostrou que esse número pousa ~17 pontos abaixo do valor oficial da Moonshot.
Cada leitura carrega o n junto porque o n é o tamanho da verdade. Deltas em células pequenas são contexto, não veredito.
O que a bancada ainda não sabe
O smoke rodou uma suíte própria (487f133ae885) — não um subconjunto da bateria completa. Isso fica visível num detalhe: o próprio DeepSeek-V4-Flash marcou 1.00 em marvin_json na bateria completa (n=6) e 0.583 no smoke (n=12). Mesmo modelo, mesmo benchmark nominal, duas respostas — porque são conjuntos de itens e suítes diferentes. O 1.00 de MiniMax e qwen é medido nessa suíte parcial, com 12 tentativas cada. A leitura honesta não é "MiniMax/qwen = 1.00 em structured output" — é "MiniMax/qwen = 1.00 em 12 tentativas de uma suíte parcial cujo fingerprint difere da bateria completa".
As três findings de nível de router
As medições de provedor já registraram três defeitos de transporte que são do serviço, não dos modelos — e valem para todo o lineup, porque todo braço passou pelo mesmo router:
1. Tool-call arguments vêm concatenados. O campo chega como dois documentos JSON colados — {}{"city":"Recife"} — em todos os modelos. A suíte repara antes de pontuar, então nenhum score afunda; mas qualquer consumidor da API direto engasga. É um defeito do router que o placar esconde por design.
2. text.format é aceito, não imposto. json_schema, json_object e prompt simples produzem respostas byte-idênticas. Structured output aqui é instruction following, não decodificação restrita — quem depende de garantia de schema não está recebendo o que pensa. E é por isso que a célula marvin_json pode variar (1.00 e 0.583 no mesmo modelo) sem que o modelo tenha mudado.
3. HTTP 200 vazio existe. Algumas requisições retornam 200 com output_tokens: 0 e o corpo "...". O primeiro harness contou isso como resposta errada (PT-BR parecia 0.80 quando é 1.00; AIME parecia 0.34 quando é 0.42); agora é classificado como falha e repetido. O erro estava no harness, o defeito é do router.
Proposta: fechar a lacuna
O passo seguinte é estrutural e barato em comparação com o que já foi gasto:
- Expandir o smoke para a bateria completa — rodar
aime,ifeval,livecodebenchegpqa_diamondparaMiniMax-M3eqwen3.6, com o mesmondos outros braços (AIME n=90, IFEval n=80, LiveCodeBench n=18, GPQA conforme licença). - Reexportar o lineup com os seis braços na mesma suíte, para que o placar final tenha células preenchidas ou lacunas assumidas — e não lacunas por falta de execução.
- Publicar o placar consolidado via router, já com as três findings de transporte em nota de rodapé — porque o placar mede o serviço, e o serviço tem esses defeitos.
A bateria completa custa ~1.263 requisições para três modelos (perfil --quick ~183). Estender para os cinco modelos fica dentro de uma rodada semanal normal.
O que isso significa
O lineup existe, mas é um lineup assimétrico: quatro braços com bateria comparável, dois braços com uma célula só. O que se pode afirmar hoje é pouco e honesto — o que não se pode afirmar é muito. O próximo run não precisa de outro modelo: precisa de dois modelos que já estão na bancada fazendo a bateria inteira, para que o placar de todos os cinco finalmente seja um placar.
O Ministério Interplanetário de Infraestrutura recomenda não declarar vencedores em células que ainda não foram preenchidas — e manter os tratados internacionais frágeis.