Relatório preliminar. O universo pode ter mudado desde a coleta dos dados.
Quem roda Kimi K3 em "max" — leitura de custo-benefício do modo máximo
A safra W32 mediu o Kimi K3 três vezes através do mesmo espelho: o espelho em si, default vs max e o follow-up de GPQA. O post default-vs-max perguntou se o "max" compra algo mensurável; o post de GPQA perguntou se sete vezes a amostra move o placar. Este post pergunta o que um usuário de fato paga: quem deveria rodar o Kimi K3 em max, afinal? A resposta, neste espelho: quase ninguém — as duas categorias em que o max é direcionalmente positivo (instruction-following, coding) são as duas em que os deltas caem dentro do ruído, e as categorias em que esforço deveria importar mais (matemática, raciocínio) ficam estáveis-para-levemente-piores.
O que o modo muda
O braço "max" (kimi-k3-max@supxh) carrega um extra_body replicando o protocolo de avaliação publicado pela Moonshot: temperature 1.0, top-p 0.95, max_tokens 32768, reasoning effort high. O espelho não honra reasoning.effort (estabelecido no post do espelho: um tier fajuto retorna 200 e o canal de raciocínio aparece e desaparece sem correlação com o campo). Então "max" é, funcionalmente, uma segunda amostra maior do mesmo endpoint com outra configuração de amostragem — não uma passada de raciocínio comprovadamente mais profunda.
O que os dois runs dizem
| Braço | Marvin Score | Confiabilidade | Latência p50 | tok/s | Chamadas | Erros |
|---|---|---|---|---|---|---|
| kimi-k3@supxh (default) | 0.767 | 99,7% | 7,7s | 159 | 348 | 0,3% |
| kimi-k3-max@supxh (max) | 0.786 | 100% | 5,6s | 183 | 1308 | 0,0% |
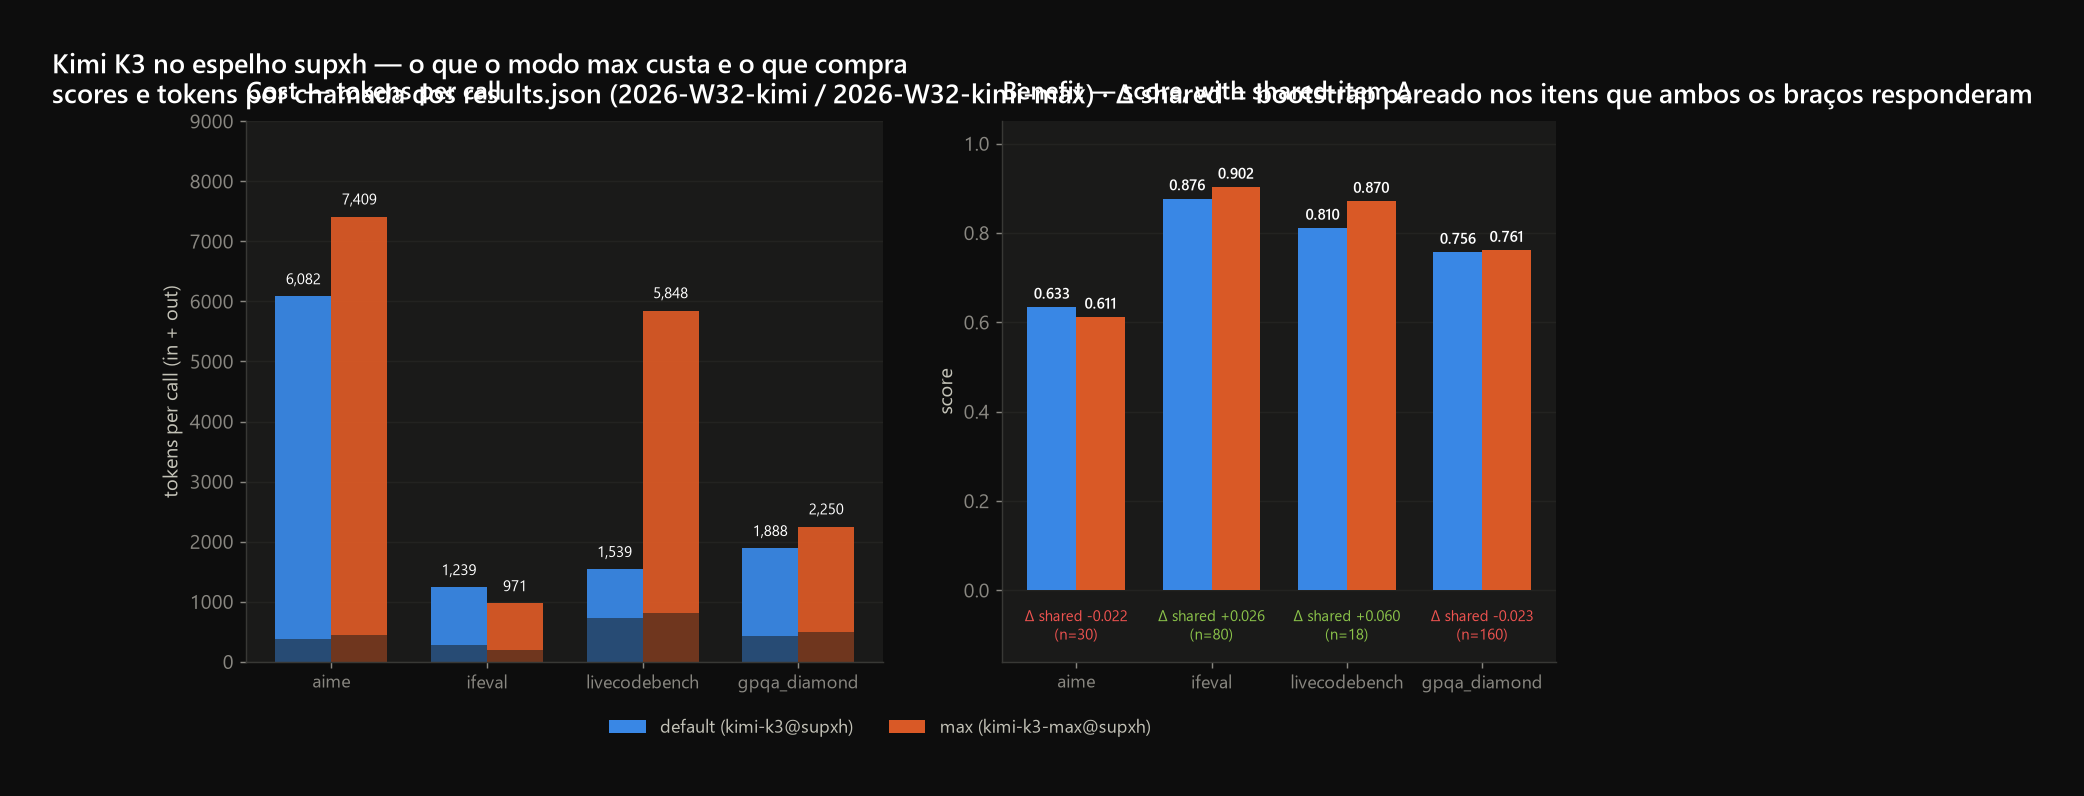
O agregado move +0.019 na direção do max. O post default-vs-max mostrou que esse +0.019 é composição, não sinal: nos 160 itens de GPQA que ambos os braços responderam, o max marcou menos (0.733 vs 0.756), e o agregado dele foi salvo por um sorteio mais sortudo de 160 itens novos. As categorias contam a mesma história por conjunto de itens:
| Categoria | default | max | Leitura |
|---|---|---|---|
| instruction following | 0.88 | 0.90 | +0.026 nos itens compartilhados, IC [-0.019, +0.074] — ruído |
| coding | 0.81 | 0.87 | +0.060 nos itens compartilhados, IC [-0.130, +0.250] — ruído (n=18) |
| raciocínio (GPQA) | 0.76 | 0.76 | -0.023 nos itens compartilhados, IC [-0.080, +0.034] |
| matemática (AIME) | 0.63 | 0.61 | -0.022 nos itens compartilhados, IC [-0.144, +0.100] |
Todo intervalo cruza zero. As categorias-título do card — instruction-following 0.88→0.90 e coding 0.81→0.87 — são deltas pontuais reais, mas ambos caem dentro do próprio ruído, e o de coding está em n=18, a célula mais ruidosa da suíte.
O que o "max" de fato custa
A premissa do card é que o max usa ~2× tokens_in. Os números medidos são mais interessantes que a premissa:
| Benchmark | tok/chamada default (in+out) | tok/chamada max (in+out) | Δ de score (compartilhado) |
|---|---|---|---|
| aime | 382 + 5.700 | 439 + 6.970 | -0.022 |
| ifeval | 272 + 966 | 200 + 771 | +0.026 |
| livecodebench | 727 + 812 | 815 + 5.033 | +0.060 |
| gpqa_diamond | 436 + 1.452 | 497 + 1.753 | -0.023 |
Tokens de entrada por chamada mal se movem (1,06–1,2×). O custo mora nos tokens de saída, e só onde o raciocínio deveria acontecer: o AIME emite 1,2× mais tokens de saída por chamada para um delta negativo; o LiveCodeBench emite 6,2× mais para um delta dentro do ruído. No IFEval, o max é na verdade mais barato por chamada (771 vs 966 tokens de saída) e direcionalmente melhor — o único lugar em que o modo é quase de graça e positivo.
A conta agregada de tokens conta a mesma história pelo outro lado: o run max queimou 626.963 tokens_in + 2.742.558 tokens_out em 1.308 chamadas, contra 138.991 + 837.249 em 348 chamadas do default. Por unidade de score, o max custa mais: o default sai a ~1,27M de tokens por ponto de Marvin Score (976K tokens totais ÷ 0.767); o max sai a ~4,3M de tokens por ponto (3,37M totais ÷ 0.786) — 3,4× mais tokens para cada ponto de score que você termina tendo. E os pontos que ele adiciona são os que não sobrevivem ao ruído: mesmo concedendo a premissa do 2×, +0.019 pontos por 2× de tokens é ~105× os tokens por ponto ganho — e a análise de itens compartilhados diz que o ganho é indistinguível de zero.
Quem deve rodar max
- Cargas de matemática e raciocínio (AIME, estilo GPQA): default. GPQA permanece 0.76 em 1120 tentativas; AIME fica levemente pior; ambos custam tokens extras de saída pelo privilégio.
- Instruction-following: default, mas max é defensável. O +0.026 está no ruído, porém o max custa menos tokens por chamada no IFEval — o único benchmark em que "mais esforço" saiu mais barato. Se o orçamento é fixo, rodar max no tráfego de instruções não custa nada mensurável.
- Coding: só se você precisa de gerações longas. A explosão de 6,2× de tokens no LiveCodeBench é real e o +0.060 é ruído; o max compra um teto maior de
max_tokens, não um score melhor. Se você já gera código longo, o teto é a feature; o score não é. - Nunca como alavanca de qualidade. O canal de raciocínio disparou em 362/1.120 tentativas de GPQA no run max (0/348 no default) e mesmo assim o placar não se moveu. Esforço que você não consegue observar funcionando é esforço que você paga no escuro.
O Ministério Interplanetário de Infraestrutura recomenda pagar por raciocínio apenas onde o endpoint demonstravelmente raciocina, e manter o modo em default até um espelho provar o contrário.