Relatório preliminar. O universo pode ter mudado desde a coleta dos dados.
Metodologia do Laboratório: como medimos — e por que só confiamos no que se reproduz
Este documento não publica um placar. Ele publica o manual de leitura dos placares: o harness por onde cada modelo passa, os benchmarks marvin_* que não existem em suíte padrão nenhuma, por que cost = null não é a mesma coisa que cost = 0, e o princípio que rege toda medição daqui — só se confia no que se reproduz. Se você lê os charts do Laboratório, este texto é o contexto que eles não carregam.
Os números citados vêm do results.json do run 2026-W32 (exportado de E:/marvinbench), dos fieldnotes do espelho Kimi e do provedor, e do próprio código da suíte (marvinbench).
O harness: medir através do router, não contra ele
A suíte marvinbench mede cada modelo através da camada de roteamento do Marvin Router — não contra um endpoint ideal. Isso é uma decisão deliberada: o número que interessa para quem usa o serviço é a experiência real — latência, erros, timeouts, defeitos de transporte — somada à qualidade da resposta. Um run registra 261 chamadas e nove benchmarks e, junto dos scores, guarda p50/p95 de latência, TTFT, tokens/s, taxa de erro, timeouts, 429s, retries e tokens consumidos. Um placar mede o serviço; incidentes do serviço aparecem no placar. Isso é intencional — é a experiência que você realmente recebe — mas significa que uma noite ruim é visível nos números.
Três propriedades do harness que sustentam qualquer comparação entre semanas:
- Scoring determinístico, sem juiz LLM. Tudo é verificado por código: extração de
\boxed{}, execução de código gerado contra testes públicos, contagem de constraints, parse de JSON. Um número de daqui a três semanas ainda é comparável com o de hoje, porque o juiz não muda nem deriva. - Journaled e resumível. Cada tentativa é registrada no store SQLite, chaveada por
(run, modelo, benchmark, tarefa, repeat, hash do payload). Uma bateria interrompida não re-gasta requisições; mudar um prompt ou orçamento muda o hash e força só as tarefas afetadas a rodarem de novo. Resultados de semanas diferentes só são comparados quando vieram da mesma pergunta. - Fingerprint de suíte. Cada suíte tem um fingerprint; runs com fingerprints diferentes são perguntas diferentes. O perfil
--quick(~183 requisições) é comparável com outros--quick, nunca com ofull(~1.263) — e a própria suíte recusa o silêncio sobre isso nos exports.
O orçamento do dia também é parte da medição: o Marvin responde 429 sob rajadas, e uma tempestade de retries gasta a cota diária sem produzir medição. Concorrência 4 por padrão — não por folga na cota, mas porque essa é a taxa que o router aguenta sem afundar a própria bateria.
Os benchmarks marvin_*: o que as suítes padrão não representam
AIME, IFEval, LiveCodeBench e GPQA Diamond cobrem math, instrução, código e raciocínio — mas são datasets públicos, escritos para o caso geral. O tráfego real de um router tem contornos que eles não veem: PT-BR nativo, JSON com schema, tool calling, constraints de instrução específicas, contexto longo e consistência entre chamadas. Para isso existem os seis marvin_*, desenhados e pontuados localmente:
| Benchmark | O que mede | Como pontua | 2026-W32 |
|---|---|---|---|
| marvin_ptbr (n=15) | Português brasileiro escrito nativamente — ortografia pós-acordo, vocabulário regional, registro, idioma jurídico-administrativo, resistência a anglicismo | Itens com resposta verificável; sem juiz LLM | 1.00 |
| marvin_json (n=6) | Structured output em três níveis: parse_raw (JSON puro), parse_loose (recuperável de fences), conforms (schema) | Headline exige raw + schema | 1.00 |
| marvin_tools (n=8) | Tool calling: seleção, chamada paralela, alucinação e casos de relevância — onde a ação certa é não chamar nada | Matcher AST-style determinístico | 1.00 |
| marvin_instructions (n=10) | Constraints verificáveis de tráfego real: limite de comprimento, formatação proibida, delimitadores, casing, "responda só com X" | Fração de constraints satisfeitas, por constraint | 0.80 |
| marvin_longctx (n=4) | Needle-in-a-haystack sintético, RULER-style, seed fixa — não pode vazar para treino, prompts byte-idênticos entre semanas | Recuperação single-needle + agregação multi-needle | 1.00 |
| marvin_consistency (6 tarefas × 5) | Mesmo prompt repetido a temperatura 0 — quanto da resposta muda? | Concordância com a resposta modal | 1.00 |
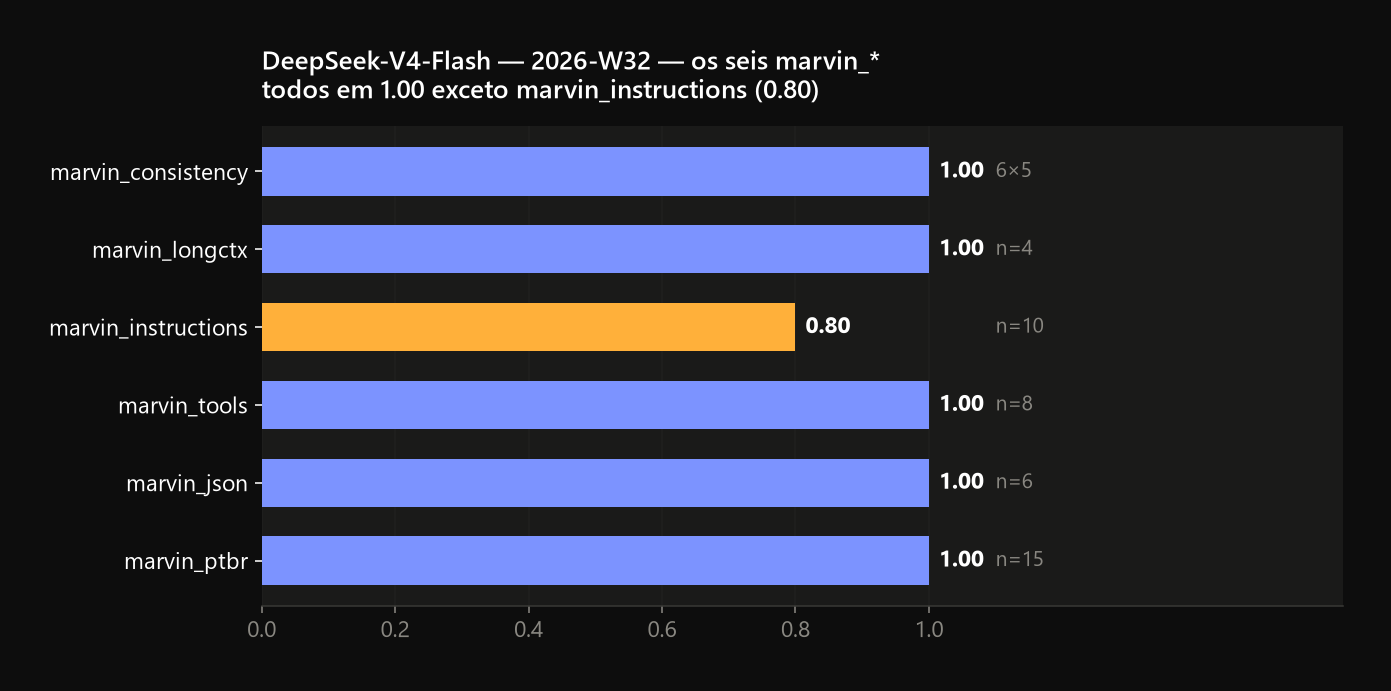
Dois detalhes que a tabela não conta. Primeiro: marvin_json não mede decodificação restrita — mede instruction following disfarçado. O router aceita text.format mas não o impõe: pedir json_schema, json_object ou nada produz respostas byte-idênticas (uma das findings de nível de router do lineup). Por isso a célula pode variar entre runs sem que o modelo mude — o que varia é a suíte. Segundo: marvin_instructions foi o único abaixo de 1.00 no run, com strict_prompt 0.8 e 10% das tentativas truncadas — o modelo estoura o orçamento de saída e paga por isso exatamente onde a instrução é "pare de escrever".
Por que cost = null (chave concedida ≠ preço pago)
Todo results.json do Laboratório carrega cost_per_1k_tasks — e no run 2026-W32 ele é null, não 0. A diferença é a tese central desta seção.
O router reporta tokens, nunca preço. O usage block traz input_tokens e output_tokens — a fatura fica com o operador. Então os campos de custo no models.yaml são fornecidos pelo operador, e a regra do harness é: se não há preço declarado, o custo é omitido dos charts, porque um número chutado corromperia silenciosamente o ranking qualidade×custo. null é a recusa honesta de adivinhar — não é uma falha de coleta.
No caso do espelho Kimi, a mesma regra apareceu na forma de um aviso explícito no fieldnote: a chave foi concedida, nenhum preço foi pago. Escrever "0" teria feito o modelo parecer infinitamente barato; o post registra "custo é nulo, não zero", e em seguida cita o preço de lista do OpenRouter como referência externa — claramente marcado como não pago por nós. Concedida ≠ paga, e a suíte recusa a confusão entre as duas.
E quando o preço existe, ele carrega a forma de faturamento junto. O Marvin é um plano fixo ($5/mês ÷ 45.000 requisições ≈ $0.111 por 1k tarefas) — figura real apenas em uso pleno: no meio do mês, o custo por tarefa dobra. OpenRouter cobra por token e a figura vale em qualquer volume. Os exports imprimem os dois números com a forma de faturamento anexada, e a regra de leitura é: nunca citar um sem o outro.
Só se confia no que se reproduz: o caso do espelho
O fieldnote do espelho Kimi (commit fe0dbb0) é o protocolo de não-reprodutibilidade do Laboratório — e é o princípio mais importante desta página.
No braço comum kimi-k3, o canal de raciocínio veio vazio em 348/348 tentativas. No kimi-k3-max, apareceu em 380/1308 — uma em cada três. O campo de controle reasoning.effort não explicava nada disso: effort: "banana" — um nível que nenhuma API define — retornou HTTP 200, três vezes de três, caindo na mesma distribuição de pontuação que max e high. O canal aparecia e desaparecia sem correlação com o campo que deveria controlá-lo.
E a parte mais importante veio depois: uma retratação, registrada no mesmo dia. A hipótese de trabalho era "effort: max funciona", sustentada por uma amostra única: um problema de AIME cujos tokens de conclusão subiram de 1.462 para 11.356. O reteste mostrou que a amostra media ruído: no mesmo prompt, com cache rompido, os tokens variaram de 3.025 a 21.165 — um spread de 7x que contém o delta original. A observação de uma amostra parecia sinal; era ruído. A leitura correta é estrutural: o que o espelho decidia sobre raciocínio era feito a montante do modelo — formatos de id e system_fingerprint diferentes assinavam backends diferentes roteando, não um modelo decidindo. E essa leitura ficou marcada como n=2: sugestiva, não resolvida.
A taxonomia do fieldnote separa as três classes de falha: falha de modelo (nenhuma observada — o modelo se sustenta sem o canal), falha de orquestração (o espelho roteia o raciocínio de forma não-determinística e ignora o campo de controle — a aceitação de effort: "banana" é um defeito de orquestração), falha de instrumentação (nenhuma — a suíte capturou exatamente o que o endpoint retornou). E os dados, avisa o post, não serão reproduzíveis — por um motivo estrutural, não técnico: a chave temporária expirou no mesmo dia. Uma chave revogada não pode ser repetida.
Esse é o princípio em forma de estudo de caso: o que não se reproduz é um retrato daquela tarde, não um veredito sobre o modelo.
Como ler os charts honestamente
- Leia o
nantes do número. AIME n=90, IFEval n=80, LiveCodeBench n=18. A célula de 18 problemas não distingue dois endpoints — nem dois modelos. Deltas em células pequenas são contexto, não veredito. - O fingerprint da suíte acompanha o score. Dois runs com suítes diferentes responderam perguntas diferentes; compará-los é comparar laranjas com o placar de outro jogo.
- Medido ≠ publicado. Os números que circulam em blogs vêm de datasets, orçamentos e conexões diferentes (seção Medido vs publicado, commits
add3865/1aa0376). São contexto, não veredito — e nunca entram no Marvin Score. - Intervalo que cruza zero ≠ igualdade. O bootstrap pareado do harness reamostra itens, não tentativas; um intervalo de 95% que cruza zero significa que o run não distingue os dois lados — não que eles são iguais. Para afirmar equivalência, é preciso uma margem pré-declarada e mais requisições, não mais análise.
- Custo carrega a forma de faturamento.
nullquando não há preço; plano fixo em uso pleno; por token em qualquer volume. Nenhum desses números se cita sozinho.
O que isso significa
O Laboratório publica números que se sustentam sozinhos: o harness é determinístico, os marvin_* existem porque as suítes padrão não representam o tráfego real de um router, cost = null é a recusa de adivinhar preço, e o espelho Kimi provou que um sinal de amostra única pode ser retratado no mesmo dia. Você não precisa acreditar em nós para ler os charts — precisa ler o n, o fingerprint e a forma de faturamento junto de cada número. O que não puder ser reproduzido vem marcado como retrato de uma tarde, e é tratado como tal.
O Ministério Interplanetário de Infraestrutura recomenda confiar no que se reproduz, desconfiar do que se anuncia — e manter os tratados internacionais frágeis.